Отказоустойчивость
Назначение документа#
Этот документ описывает поддерживаемую отказоустойчивую схему развертывания SmartCPD на уровне архитектуры.
Документ отвечает на вопросы:
- какая HA-схема считается базовой и поддерживаемой;
- какие роли нод обязательны;
- как распределяются manager-роли Docker Swarm;
- как ведут себя разные контуры решения при отказе ноды;
- какие инфраструктурные ограничения обязательны для такой схемы.
Другие варианты HA в этом документе не рассматриваются.
Базовая модель#
SmartCPD использует двухуровневую модель отказоустойчивости:
- сервисный контур работает по модели высокой доступности с перезапуском компонентов на резервной ноде;
- продуктивный контур работает по модели graceful degradation: при отказе части нод система продолжает обрабатывать новые вызовы, но потеря текущих активных вызовов на упавшей ноде допустима.
Практически это означает следующее:
- сервисные компоненты должны переживать отказ одной ноды без потери работоспособности решения в целом;
worker-ноды масштабируются горизонтально и при отказе части нод дают управляемую деградацию производительности;balancer- иanalyzer-ноды резервируются только в объеме, который реально нужен для данной инсталляции.
Поддерживаемая HA-конфигурация#
Поддерживаемая схема High Availability для SmartCPD:
- минимум 3 ноды Docker Swarm;
- минимум 2 ноды с ролью
service; - минимум 2
worker-ноды; - минимум 2
balancer-экземпляра; - обе
service-ноды должны бытьmanager; - третья
manager-нода размещается на наименее нагруженной ноде; - лучший кандидат на роль третьего
manager— резервныйbalancer; - если отдельного резервного
balancerнет, в компактной схеме третийmanagerразмещается на одном изworker; - выделенный
analyzerможно использовать как третьегоmanager, только если его нагрузка это допускает; - если всего в кластере 3 ноды, все 3 ноды должны быть
manager.
Другие варианты quorum-модели в рамках публичной архитектуры не поддерживаются и не рекомендуются.
Схема ролей#
Поддерживаемая схема ролей и внешних зависимостей показана на рисунке ниже.
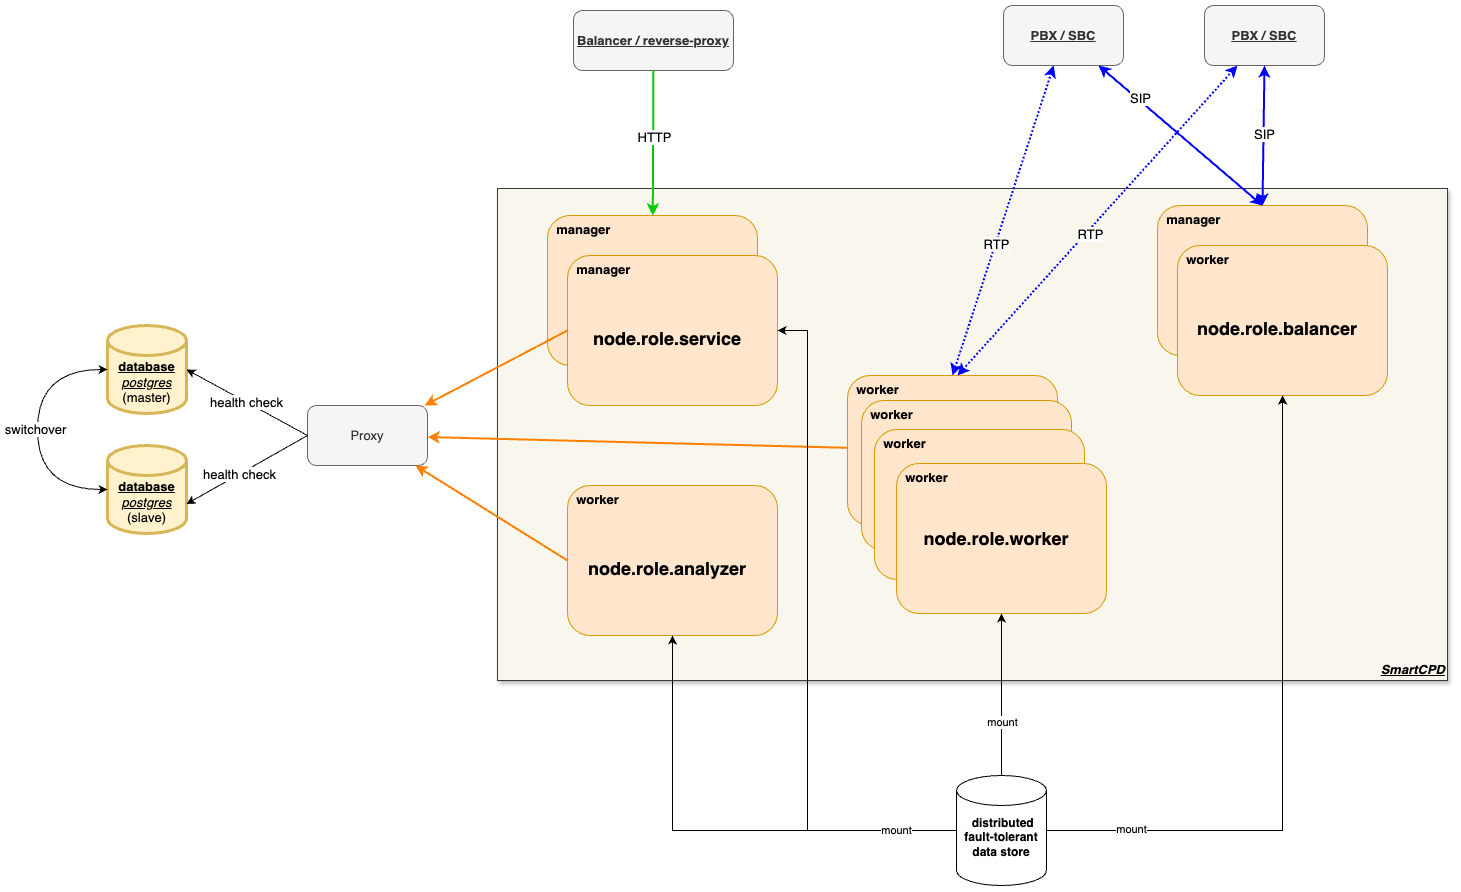
Минимальная HA-схема не означает минимум 6 отдельных серверов. Роли могут совмещаться, если это допускает расчетная нагрузка.
Shared storage#
Для отказоустойчивого сервисного контура должно использоваться отказоустойчивое распределенное хранилище данных, доступное на всех service-нодах по одному и тому же пути.
Конкретный состав данных, которые в текущей схеме поставки должны размещаться в общем хранилище, описан в разделе Отказоустойчивое распределенное хранилище данных.
В не-HA схеме допускается использование локального хранилища, но в таком случае резервное копирование должно быть организовано отдельно.
База данных#
Отказоустойчивость PostgreSQL не входит во внутренний HA-контур SmartCPD и должна обеспечиваться в зоне ответственности заказчика.
SmartCPD предполагает, что:
- PostgreSQL развернут и сопровождается отдельно от стека SmartCPD;
- отказоустойчивая схема БД проектируется заказчиком в соответствии с его инфраструктурными требованиями;
- доступность БД не обеспечивается средствами Docker Swarm внутри поставки SmartCPD;
- со стороны SmartCPD БД публикуется через единый внешний endpoint.
Текущая поставка SmartCPD не поддерживает указание нескольких DB endpoints.
Поэтому переключение между экземплярами БД должно быть скрыто за единым внешним endpoint инфраструктуры Заказчика, например за HAProxy или аналогичным балансировщиком.
При отказе БД вызовы продолжают обслуживаться, но происходит деградация управляющего и отчетного контуров.
При этом текущая архитектура не гарантирует буферизацию и последующую повторную запись CDR, сформированных во время недоступности PostgreSQL. Такие CDR могут быть безвозвратно потеряны, что приведёт к неполноте статистики, истории вызовов и данных, используемых последующими расчетами.
Практические последствия отказа БД:
- частичная деградация конфигурационного слоя;
- полная деградация портала, включая авторизацию;
- полная деградация внешних API, зависящих от портала и конфигурационной БД;
- риск потери CDR, сформированных во время недоступности PostgreSQL;
- деградация отчетности и доступа к CDR/историческим данным.
Сервисный контур#
Сервисный контур является обязательной частью HA-схемы.
Требования:
- должно быть 2
service-ноды; - обе
service-ноды должны использовать общее хранилище для сервисов, которым требуется переносимое состояние; - обе
service-ноды должны входить в manager quorum Docker Swarm.
На service-нодах размещаются основные сервисы управления и сопровождения решения. Большинство таких сервисов работает в одном экземпляре. При отказе ноды экземпляр перезапускается на второй service-ноде автоматически.
Это относится в первую очередь к тем компонентам, для которых важна непрерывность управляющих и инфраструктурных функций:
- портал и API управления;
config-server;metrics;grafana;- лицензирование, биллинг и другие сервисные компоненты;
- внутренние Redis-компоненты, если они используются внутри поставки.
HA для сервисного контура предполагает короткий failover, а не полностью бесшовную работу без паузы.
Продуктивный контур#
Продуктивный контур включает worker, balancer и analyzer.
Worker#
worker-ноды масштабируются горизонтально в режиме active-active.
Принципы:
- минимально для отказоустойчивой продуктивной схемы требуется не менее 2
worker-нод; - увеличение количества
worker-нод используется прежде всего для наращивания производительности; - при отказе одной
worker-ноды активные вызовы на ней могут быть потеряны; - новые вызовы продолжают обслуживаться оставшимися нодами, если у кластера хватает ресурса.
Balancer#
balancer-ноды используются в режиме active-active.
Принципы:
- для отказоустойчивой схемы требуется 2
balancer-экземпляра; - более 2
balancer-нод обычно не требуется; - в типовой HA-схеме одна из
balancer-нод является лучшим кандидатом на роль третьегоmanager; - отказоустойчивость этого контура достигается только если внешняя SIP-инфраструктура умеет направлять трафик на оба
balancer-экземпляра или переключаться между ними; - при отказе одной
balancer-ноды активные вызовы на ней могут быть потеряны, но новые вызовы продолжают поступать через оставшийсяbalancer, если внешняя схема маршрутизации это поддерживает.
Analyzer#
analyzer не участвует в базовом service failover, но для HA-схемы должен рассматриваться как отдельный контур размещения.
Принципы:
- в большинстве инсталляций достаточно одной
analyzer-ноды; - при необходимости можно использовать 2
analyzer-ноды; - резервирование
analyzerнужно прежде всего для сокращения простоя функции самообучения, а не для непрерывности обработки каждого отдельного вызова. - для HA-инсталляции
analyzerрекомендуется размещать на отдельной ноде; - если роли
serviceиbalancerсовмещены на одних и тех же нодах, отдельная нода дляanalyzerдолжна считаться обязательной; - отказ
analyzerне останавливает основной процесс обработки вызовов, но влияет на самообучение и связанные аналитические функции; - причина в том, что фактическая нагрузка
analyzerсильно зависит от реального характера трафика, в том числе от доли роботов и объема повторного анализа.
Типовые схемы#
Компромиссная HA-схема на 3 серверах#
Это самый компактный поддерживаемый вариант для небольшой нагрузки.
Он подходит для случаев, когда:
сервисный контур критичен и должен переживать отказ одной ноды;
общая нагрузка невысока;
при этом нет задачи сразу строить типовую полноразмерную HA-схему.
нода 1:
service+balancer+managerнода 2:
service+balancer+analyzer+managerнода 3:
worker+manager
Такая схема допустима только если нагрузка позволяет совмещать роли service и balancer.
Это компромиссная HA-модель, а не типовой рекомендуемый вариант для новой продуктивной инсталляции.
Статус analyzer в этой схеме:
- отдельная нода под
analyzerне выделяется; analyzerразмещается на ноде 2 вместе с сервисным контуром;- использовать такую схему следует только при небольшой нагрузке.
Компактная HA-схема на 4 серверах#
Это базовый практический вариант для большинства инсталляций.
- нода 1:
service+balancer+manager - нода 2:
service+balancer+analyzer+manager - нода 3:
worker+manager - нода 4:
worker
В этой схеме:
- обеспечиваются 2
service-ноды; - обеспечиваются 2
balancer-экземпляра; - обеспечиваются минимум 2
worker-ноды; - третий
managerразмещается на одном изworker, потому что отдельного резервногоbalancerнет.
Статус analyzer в этой схеме:
- отдельная нода под
analyzerв саму схему еще не входит; analyzerразмещается на ноде 2 вместе с сервисным контуром;- при этом для продуктивной HA-инсталляции рекомендуется сразу планировать отдельную ноду под
analyzerнезависимо от текущей нагрузки; - это позволяет не возвращаться к перестройке схемы при росте доли роботов и аналитической нагрузки.
Рекомендуемая HA-схема с отдельным analyzer#
Если важна предсказуемость производительности и устойчивость сервисного контура, analyzer должен размещаться на отдельной ноде.
Такой вариант рекомендуется по умолчанию для HA-инсталляции, потому что фактическая нагрузка analyzer сильно зависит от реального характера трафика, в том числе от доли роботов и объема повторного анализа.
- нода 1:
service+balancer+manager - нода 2:
service+balancer+manager - нода 3:
worker+manager - нода 4:
worker - нода 5:
analyzer
Схема с выделенным резервным balancer#
Если balancer вынесен на отдельные ноды, лучшим кандидатом на роль третьего manager становится резервный balancer.
Такой вариант предпочтителен для более нагруженных инсталляций, где сервисный контур не должен одновременно нести и сервисную, и балансировочную нагрузку.
Manager quorum#
Docker Swarm сохраняет управляемость кластера, пока число активных manager-нод остается не ниже N/2+1 от общего числа manager-нод.
Практически это означает следующее:
- при потере quorum кластер теряет нормальную управляемость на уровне Swarm;
- поэтому для базовой отказоустойчивой схемы SmartCPD требуется не менее 3
manager-нод; - именно из этого требования следует правило, что в минимальной HA-конфигурации все 3 ноды должны быть
manager.
Для отказоустойчивой схемы SmartCPD используется только одна рекомендуемая модель manager quorum:
- два
managerвсегда размещаются наservice-нодах; - третий
managerразмещается на наименее нагруженной ноде; - лучший кандидат: резервный
balancer; - в компактной схеме без отдельного резервного
balancer: один изworker; - выделенный
analyzerдопустим как третийmanager, только если его нагрузка это позволяет; - если кластер состоит только из трех нод, все они должны быть
manager.
Эта схема нужна, чтобы:
- сохранить работоспособность Swarm при отказе одной ноды;
- не концентрировать quorum только на сервисном контуре;
- не размещать дополнительную manager-нагрузку на наиболее тяжелых продуктивных нодах без необходимости.
Сценарии с пятью manager в рамках стандартной архитектуры SmartCPD не рассматриваются.
Требования к сети и размещению#
Поддерживаемая HA-схема предполагает один инфраструктурный контур с предсказуемой связностью между нодами.
Обязательные требования:
service-ноды и общее хранилище должны находиться в одном низколатентном сетевом контуре;- связность между всеми нодами кластера должна быть стабильной и симметричной;
- отказоустойчивость единого внешнего endpoint PostgreSQL должна обеспечиваться инфраструктурой заказчика;
- схема доставки SIP-трафика до
balancer-нод также должна быть отказоустойчивой со стороны инфраструктуры заказчика; - отказоустойчивая схема не предполагает stretched cluster между площадками с заметной межсайтовой задержкой;
- межплощадочная и geo-distributed HA в рамках стандартной схемы не поддерживаются.
Общие требования к качеству сети между нодами Docker Swarm cluster одинаковы для HA- и не-HA-инсталляций и описаны в разделе Требования к качеству сети.
Практически это означает, что SmartCPD HA нужно рассматривать как схему для одного дата-центра или одного близкого инфраструктурного контура, а не как распределенную multi-site архитектуру.
Что обеспечивает эта схема#
При соблюдении описанной модели решение обеспечивает:
- сохранение работоспособности сервисного контура при отказе одной
service-ноды; - сохранение quorum Docker Swarm при отказе одной ноды;
- продолжение обработки новых вызовов при отказе части
worker-нод; - отказоустойчивую работу SIP-балансировки при наличии двух
balancer-нод.
Ограничения схемы:
- сохранение активных вызовов на упавшей
worker-ноде; - бесшовный zero-downtime failover всех сервисов без краткой паузы;
- распределенную geo-HA между удаленными площадками.
