Логирование и мониторинг
Этот документ описывает встроенный observability-контур SmartCPD и границы его применения.
В стандартную поставку входят компоненты для мониторинга:
log2fileдля файлового архива логов;docker-health-exporterдля контроля health-состояния контейнеров;metricsкак встроенный контур сбора и хранения метрик;grafanaс преднастроенными панелью состояния компонентов и оповещениями о недопустимых событиях.
Этой функциональности достаточно для базового оперативного мониторинга продукта SmartCPD:
- оперативной проверки состояния сервисов;
- просмотра исторических логов;
- контроля базовых health-сигналов;
- использования метрик продукта и платформы.
При этом встроенный observability-контур не заменяет внешний мониторинг инфраструктуры. Контроль ресурсов хостов, дисков, сети, контейнерного runtime, сетевого хранилища и самого observability-контура со стороны внешних средств мониторинга остается рекомендуемой частью промышленной эксплуатации.
Логирование#
В стандартной поставке SmartCPD используются два встроенных механизма работы с логами:
- стандартные
docker logsдля быстрого анализа текущей ситуации или близкого к текущему периода; log2fileдля хранения исторических логов и анализа за более длительный интервал.
Оперативные логи Docker#
Стандартные docker logs и docker service logs предназначены для оперативной диагностики: когда нужно быстро посмотреть, что происходит сейчас или происходило незадолго до момента анализа.
По умолчанию для контейнерных логов используется ограниченный локальный буфер: 100 MB на контейнер в виде двух файлов по 50 MB без сжатия. Эти параметры задаются скриптом установки и могут быть изменены.
Такой режим выбран намеренно:
- он не дает логам бесконтрольно разрастаться;
- позволяет быстро получить достаточный объем свежих данных для диагностики;
- не создает лишнюю нагрузку на диски и CPU из-за локального архивирования и компрессии.
Исторические логи log2file#
log2file является встроенным сервисом хранения исторических логов SmartCPD.
Он запускается на каждой ноде и в реальном времени забирает логи контейнеров у Docker, формируя файловый архив по дням, сервисам и нодам.
Структура хранения логов:
YYYY-MM-DD/<service>/<node>/...
log2file:
- контролирует глубину хранения логов в днях;
- контролирует общий занятый объем;
- может использовать как локальные директории нод, так и общую сетевую директорию;
- поддерживает единое хранилище логов для всего контура.
Основные параметры log2file задаются при установке:
- путь сохранения логов;
- глубина хранения в днях;
- максимальный общий размер архива;
- время выполнения ежедневной очистки.
Очистка и хранение#
Очистка выполняется в два этапа:
- Сначала удаляются дни, вышедшие за пределы заданного retention.
- Если после этого архив все еще превышает допустимый размер, дополнительные данные удаляются целыми днями от старых к новым.
Логи за текущий день при size cleanup не удаляются.
При использовании общей директории хранения log2file остается конкурентно безопасным:
- запись логов идет в раздельные файловые пространства по дням, сервисам и нодам;
- процесс удаления старых файлов использует lock-механизм, чтобы не допустить конфликтов во время очистки.
При старте стека “с нуля” Docker Swarm не гарантирует полный порядок запуска сервисов, поэтому на конкретной ноде архивирование логов начинается с момента запуска контейнера
log2fileна этой ноде. Это нормальное и ожидаемое поведение для первичного запуска, который должен сопровождаться инженером. В штатной работе после запускаlog2fileархивирование логов выполняется непрерывно. При обновлении самого сервисаlog2fileвозможна потеря части логов за время его перезапуска, но обновление остальных компонентов на полноту исторического архива не влияет.
Область сбора логов#
По умолчанию log2file собирает только логи сервисов основного swarm stack SmartCPD. Это сделано специально, чтобы не занимать место логами посторонних контейнеров и не смешивать продуктовые данные с инфраструктурными или вспомогательными сервисами.
При необходимости через compose.override.yml можно явно включить архивирование отдельных сервисов или контейнеров, не входящих в основной stack.
Пример override:
services:
  log2file:
    environment:
      SMARTCPD_OBSERVE_SERVICES: "<service1>,<service2>"
      SMARTCPD_OBSERVE_CONTAINERS: "<container1>,<container2>"
Для таких изменений рекомендуется использовать отдельный compose.override.yml, чтобы настройка жила отдельно от базовой конфигурации, сохранялась при обновлениях и могла быть затем удалена без изменения базового setup-контракта.
Уровни логирования компонентов SmartCPD#
Для диагностики отдельных проблем может потребоваться изменить уровень логирования конкретного компонента SmartCPD. Такие изменения также рекомендуется выполнять через compose.override.yml.
Пример override:
services:
  <service>:
    environment:
<ENV_VAR>: "<value>"| Сервис | Переменная | Значения |
|---|---|---|
redis | --loglevel (cmd arg) | debug verbose notice warning |
config-server | LOG_LEVEL | trace debug info warn error fatal panic |
portal-api | DEBUG | 0, 1 |
cloud-connector | LOG_LEVEL | trace debug info warn error fatal panic |
license-server | LOG_LEVEL | trace debug info warn error fatal panic |
billing-server | LOG_LEVEL | TRACE DEBUG INFO WARN ERROR |
| LOG_DB_LEVEL | TRACE DEBUG INFO WARN ERROR | |
| LOG_HTTP_LEVEL | TRACE DEBUG INFO WARN ERROR | |
markup-api | LOG_LEVEL | trace debug info warn error fatal panic |
resolver | LOG_LEVEL | trace debug info warn error fatal panic |
metrics | VM_loggerLevel | INFO WARN ERROR FATAL PANIC |
grafana | GF_LOG_LEVEL | debug info warn error critical |
analyzer | LOG_LEVEL | TRACE DEBUG INFO SUCCESS WARNING ERROR CRITICAL |
balancer | O_LOGLEVEL | -3(Alert), -2(Critical) -1(Error) 1(Warning) 2(Notice) 3(Info) 4(Debug) |
mgw | O_LOGLEVEL | -3(Alert), -2(Critical) -1(Error) 1(Warning) 2(Notice) 3(Info) 4(Debug) |
dircleaner | DEBUG | 0, 1 |
smartcpd | SCPD_LOG_LEVEL | TRACE DEBUG INFO SUCCESS WARNING ERROR CRITICAL |
| LOG_LEVEL | trace debug info warn error fatal panic | |
log2file | VECTOR_LOG | trace debug info warn error off |
Для быстрого разового изменения можно использовать
docker service update --env-add <ENV_VAR>=<value> <service_name>. Это удобно для оперативной диагностики, но такой способ не является постоянной конфигурацией. Также нужно учитывать, что при таком обновлении Docker Swarm перезапускает все инстансы соответствующего сервиса.
Не рекомендуется одновременно включать подробный уровень логирования для большого числа сервисов на продуктивном трафике. Это может заметно увеличить нагрузку на диски, сеть, Docker runtime и систему хранения логов.
Статус компонент и оповещения о недопустимых событиях#
За контроль состояния компонентов SmartCPD и оповещения о недопустимых событиях отвечает встроенный health-контур:
docker-health-exporterзапущен на каждой ноде и собирает статусы контейнеров;metricsсобирает и хранит метрики отdocker-health-exporter;grafanaиспользует эти метрики для отображения dashboard и формирования оповещений.
Данные в health-контуре и построенные на них оповещения не работают в реальном времени. Фактическая задержка зависит от
SCRAPE_INTERVALи в худшем случае может достигатьSCRAPE_INTERVAL * 3. Значение15sявляется рекомендуемым и сбалансированным: меньший интервал повышает нагрузку на контур сбора и ускоряет рост хранилищаmetrics, а больший интервал снижает чувствительность dashboard и alerts и может уже не укладываться в заданные окна деградации и restart detection.
Дашборд Health#
Дашборд Health доступен во встроенной Grafana решения.
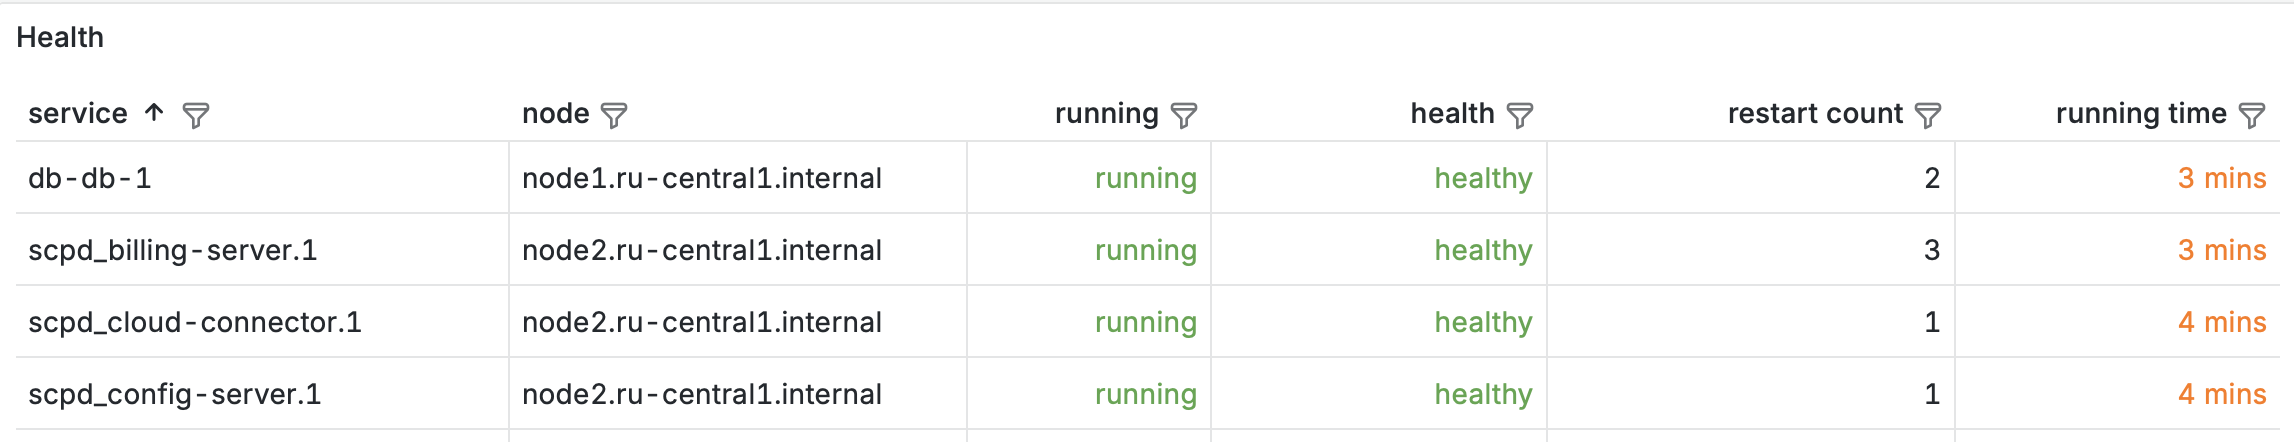
По умолчанию дашборд показывает окно наблюдения 3 дня. Если за этот период по компоненту больше нет метрик, он перестает отображаться в списке.
На дашборде отображаются:
- статус запуска контейнера (
runningилиstopped); - health-статус контейнера (
healthy,starting,unhealthy); - количество перезапусков;
- время работы с момента последнего запуска.
Для времени работы используются пороги по умолчанию:
- менее
1минуты - красный; - менее
5минут - оранжевый; - после этого значение считается штатным.
Цифра после имени сервиса соответствует номеру реплики. Это важно, потому что несколько реплик одного сервиса могут одновременно работать на одной ноде.
Количество перезапусков на dashboard используется как мониторинговый индикатор и может отличаться от точного числа всех кратковременных restart-событий, если сервис перезапускался очень часто за короткий интервал. Для задач мониторинга этого достаточно, поскольку сам факт нестабильности и наличие повторных перезапусков при этом остаются видимыми.
Оповещения#
Во встроенной Grafana преднастроены четыре alert rule.
Component Down#
Срабатывает, если контейнер на ноде был замечен в окне наблюдения, но сейчас не находится в состоянии running.
Поведение:
- сигнал остается релевантным, пока компонент виден в окне наблюдения;
- если по нему нет данных дольше
3дней, он так же перестает учитываться.
Component Restarted#
Срабатывает, если контейнер на ноде был запущен недавно.
Поведение по умолчанию:
- критический уровень: контейнер был запущен менее
1минуты назад;
На Health dashboard дополнительно используется визуальный warning-порог:
- значение менее
5минут подсвечивается как warning, но отдельное warning-оповещение для этого порога не отправляется.
Observability Degraded#
Срабатывает, если от docker-health-exporter перестали приходить свежие метрики по конкретной ноде.
Обычно это означает одно из двух:
- контейнер
docker-health-exporterна ноде не работает; - сама нода недоступна или отрезана от контура сбора метрик.
Как и в Health dashboard, нода учитывается только в пределах окна наблюдения 3 дня.
Metrics Degraded#
Срабатывает, если в metrics не появляются новые строки метрик.
Это означает, что нужно проверять сам контур ingest метрик: metrics, datasource в grafana, сетевую связность или upstream-источник метрик.
Настройка через override#
Параметры health-контура могут быть изменены через compose.override.yml.
Пример:
services:
  metrics:
    environment:
      SCRAPE_INTERVAL: "15s"

  grafana:
    environment:
      SCRAPE_INTERVAL: "15s"
      HEALTH_COMPONENT_STALE_WINDOW: "3d"
      HEALTH_DEGRADATION_DATA_MISSING_WINDOW: "3m"
      HEALTH_COMPONENT_RESTART_CRITICAL_WINDOW: "1m"
      HEALTH_COMPONENT_RESTART_WARNING_WINDOW: "5m"

  docker-health-exporter:
    environment:
      SCRAPE_INTERVAL: "15"
Важно: формат
SCRAPE_INTERVALзависит от компонента. Дляmetricsиgrafanaиспользуется duration-формат с единицей времени, например15s,1m,3m. Дляdocker-health-exporterиспользуется целое число секунд, например15.
Назначение параметров:
SCRAPE_INTERVALвmetricsиgrafanaопределяет ожидаемую частоту обновления health-метрик;HEALTH_COMPONENT_STALE_WINDOWзадает окно наблюдения, в пределах которого компонент или нода считаются известными системе;HEALTH_DEGRADATION_DATA_MISSING_WINDOWзадает интервал отсутствия свежих данных, после которого observability-контур считается деградировавшим;HEALTH_COMPONENT_RESTART_CRITICAL_WINDOWзадает критический порог для недавно перезапущенного контейнера;HEALTH_COMPONENT_RESTART_WARNING_WINDOWзадает warning-порог для короткого времени работы после запуска.
Под “известными системе” здесь понимаются компоненты и ноды, по которым в пределах окна наблюдения уже были получены метрики. Если данных за это окно не было, Grafana перестает показывать их в
Healthdashboard и не использует их в соответствующих сигналах деградации. Поэтому этот контур не подтверждает сам по себе, что все ожидаемые компоненты уже запущены: он показывает состояние тех компонентов, по которым были получены данные и/или зафиксированы изменения. Контроль полного запуска после установки, обновления или восстановления должен выполняться отдельно.
Эти параметры влияют одновременно и на поведение alert rules, и на то, как соответствующие сигналы интерпретируются на Health dashboard.
Настройка доставки оповещений#
По умолчанию все встроенные оповещения отправляются в contact point grafana-default-email.
Настройка этого contact point доступна администратору SmartCPD через веб-интерфейс Grafana.
Если требуется более сложная схема доставки, маршрутизации или группировки оповещений, нужно использовать штатные механизмы Grafana Alerting:
Требования к мониторингу контура эксплуатации SmartCPD#
Встроенный monitoring-контур не снимает необходимость контролировать состояние инфраструктуры, на которой работает решение.
Отдельного контроля требует сам встроенный monitoring-контур SmartCPD. Обязательно рекомендуется мониторить endpoint:
https://<fqdn>/grafana/health
Если grafana недоступна, встроенные оповещения не будут доставляться. Проверка этого endpoint не требует авторизации, но имеет ограничение частоты запросов не более 10 в минуту.
Минимально рекомендуется обеспечить внешний мониторинг:
- доступности сети и сетевой связности между узлами контура;
- загрузки хостов по CPU;
- использования RAM и swap;
- disk I/O;
- заполнения и состояния файловых систем и дисков.
Для этих проверок должны быть настроены оповещения и пороги срабатывания, особенно для состояния и заполнения дисков. В качестве одного из типовых вариантов такого мониторинга может использоваться Zabbix или аналогичная внешняя система.
Отдельно должна мониториться СУБД, хотя она и не входит в состав поставки SmartCPD. Минимально рекомендуется контролировать:
- доступность PostgreSQL;
- загрузку и базовые признаки деградации;
- наличие long queries длительностью более
1секунды.
В качестве дополнительного источника данных можно использовать
cAdvisorили аналогичное средство для мониторинга состояния контейнеров и потребления ресурсов на уровне контейнерной среды. Это может упростить анализ проблем производительности, деградации сервисов и неравномерного распределения нагрузки между контейнерами.
Рекомендации по мониторингу параметров SmartCPD#
Ниже приведены рекомендованные дополнительные параметры мониторинга, специфичные для продукта SmartCPD.
Worker-нода#
Для worker-нод рекомендуется выделять отдельный набор внешних проверок, поскольку именно на них выполняется основной контур обработки вызовов и именно здесь чаще всего проявляются пиковые нагрузки по CPU, памяти и disk I/O.
Минимально рекомендуется контролировать:
- загрузку CPU и признаки устойчивого насыщения по CPU;
MemAvailableна хосте;- использование swap и признаки активного свопинга, особенно
swap-in; - disk I/O и задержки дисковой подсистемы;
- заполнение локальных файловых систем, используемых для данных
worker-ноды.
Особое внимание следует уделять сочетанию трех признаков:
- росту задержек обработки вызовов;
- снижению доступной памяти;
- регулярному чтению страниц из swap.
Такое сочетание обычно указывает на давление на память и деградацию worker-ноды под нагрузкой. В этом случае рекомендуется уменьшать плотность нагрузки на ноду или увеличивать объем RAM. Подробности по интерпретации swap и memory pressure описаны в документе Troubleshooting.
Расширенные настройки#
Встроенные средства мониторинга и логирования SmartCPD не отменяют возможность использования сторонних решений и могут быть частично отключены, если их функции уже покрыты внешним контуром эксплуатации.
Это позволяет избежать дублирования сигналов, хранения одинаковых данных в нескольких системах и избыточной нагрузки на инфраструктуру. При этом решение об отключении отдельных встроенных компонентов должно приниматься осознанно, с пониманием того, какая внешняя система берет на себя соответствующую функцию.
Использование внешних систем логирования#
Контракт логирования сервисов SmartCPD в контейнерах основан на записи логов в stdout/stderr.
Это упрощает подключение внешних систем агрегации логов без изменения приложений и без внедрения специальной логики в сами сервисы SmartCPD.
Docker поддерживает встроенные logging drivers, которые могут использоваться для интеграции с внешним логированием, например:
json-file;journald;syslog;gelf;fluentd;splunk.
Также могут использоваться внешние и plugin-based решения сбора и доставки логов, например:
Loki;Logstash;OpenTelemetry Collector;Vector;Fluent Bit.
В таких сценариях встроенный log2file может быть отключен, если историческое хранение, поиск и выгрузка логов уже реализованы во внешней системе логирования.
Если выбранный logging driver или внешний агент доставки логов сразу передает события во внешний контур и локальное хранение на стороне Docker не требуется, стандартное локальное файловое хранение docker-логов также может быть отключено.
Использование внешних систем мониторинга контейнеров и хостов#
Мониторинг сервисов SmartCPD, работающих в Docker-контейнерах, может быть реализован средствами внешнего мониторинга контейнерной среды и хостовой инфраструктуры.
Для этого могут использоваться, например:
cAdvisor;Zabbix;Prometheus;Grafana Alloy;Datadog;Netdata;Telegraf.
SmartCPD не требует строго определенного внешнего средства мониторинга контейнеров, если выбранное решение позволяет контролировать:
- состояние контейнеров и сервисов;
- использование CPU, RAM, swap, network и disk I/O;
- базовые признаки деградации контейнерного runtime и хостовой среды.
Использование встроенных метрик во внешних системах#
Встроенный компонент metrics доступен по HTTP API и может использоваться как источник данных для внешних систем мониторинга и аналитики.
Это позволяет:
- строить собственные dashboard;
- формировать внешние alert rules;
- использовать продуктовые и платформенные метрики SmartCPD в общей системе мониторинга эксплуатации.
Использование встроенной Grafana#
Встроенная grafana может использоваться не только как готовый интерфейс базового мониторинга, но и как источник готовых dashboard и пример использования продуктовых метрик SmartCPD.
Это может быть полезно в случаях, когда:
- требуется встроить продуктовые сигналы SmartCPD во внешнюю систему мониторинга;
- нужно быстро понять, какие метрики и панели уже считаются базовыми для эксплуатации;
- требуется перенести существующие панели или их логику во внешний observability-контур.
