Troubleshooting
Этот документ служит базовой опорной точкой для технической диагностики SmartCPD. Здесь собраны первичные проверки, примеры логов и признаки типовых проблем, которые помогают быстро понять, куда смотреть в первую очередь.
SmartCPD анализирует вызов на наличие человека на линии, отсекая тишину, автоответчики и роботов. Для этого система использует запись до соединения и до 8 секунд после соединения.
В ходе обработки выполняются, в частности, следующие проверки:
- время, затраченное на снятие трубки;
- наличие специальных тонов;
- соответствие локальной и облачной баз шаблонов Dejavu;
- LSTM-классификация;
- анализ ключевых слов через VOSK.
По результатам обработки SmartCPD классифицирует вызов и сохраняет запись для дальнейшего анализа в analyzer.
Основные рабочие директории и интерфейсы:
- чтение записей из локального тома
node_records; - сохранение классифицированных записей в локальный том
node_results; - публикация
tcp:5544для доступа локального экземпляраamd; - передача статистических метрик и получение событий обновления моделей через Docker overlay network.
Первичная диагностика работы SmartCPD#
Глобальные настройки#
Откройте веб-интерфейс системы и перейдите в раздел «Глобальные настройки». Убедитесь, что загружены актуальные модели Dejavu и LSTM, а также проверьте срок действия лицензии в этом же разделе.
Метрики#
Перейдите во вкладку «Метрики».
Вкладка «Ключевые показатели»#
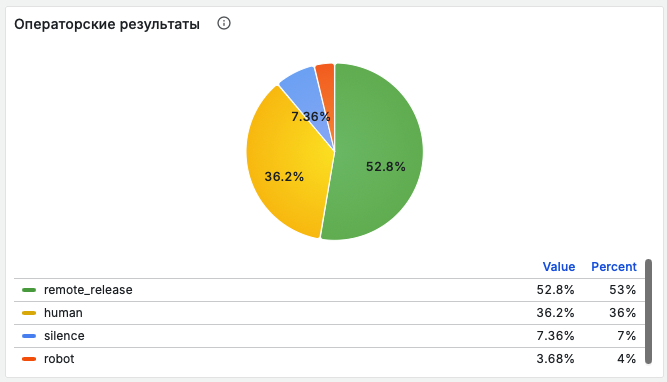
Проверьте, не наблюдается ли резкого увеличения доли роботов по сравнению с предыдущими днями.
Примеры:
Нормальное количество роботов на операторе:
Резкое повышение до 20%:
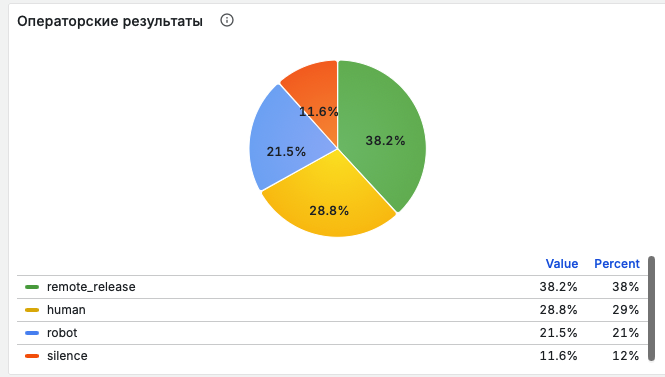
Нормальное значение процента роботов зависит от конкретного контура и определяется на основании его исторических значений. Устойчивое превышение этого показателя более чем в 2 раза в течение 2 часов и более является основанием для обращения к вендору.
Вкладка «Распознавание SmartCPD»#
Проверьте наличие задержек в обработке.
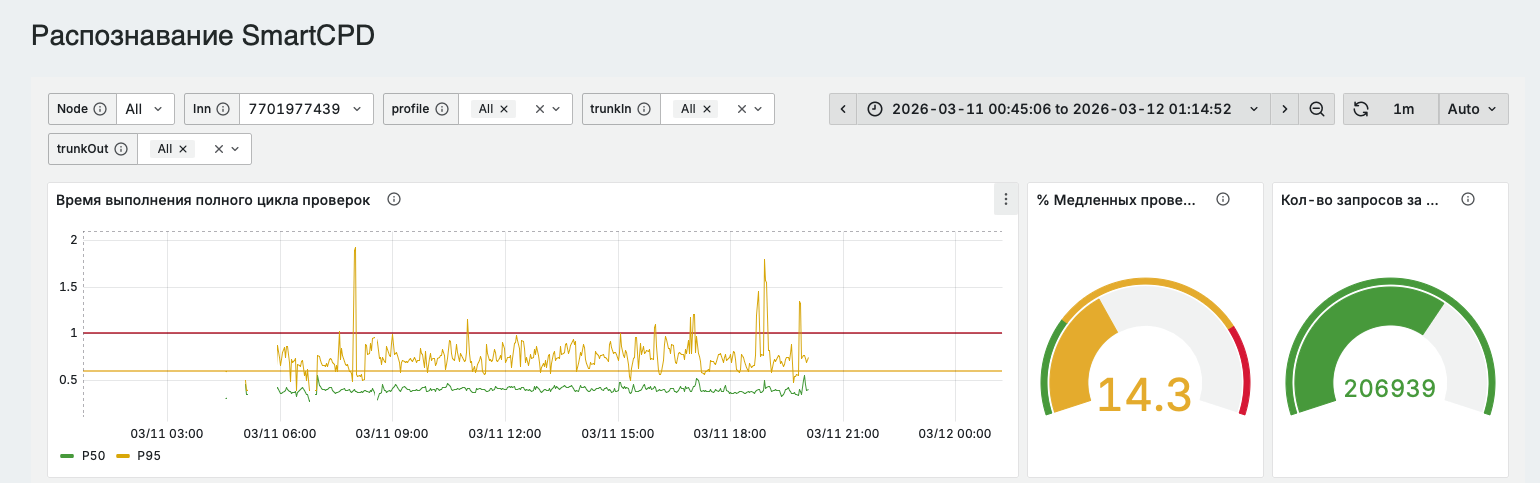
При наличии задержек следует обратиться к вендору или добавить worker-ноды.
Проверка работы SmartCPD#
docker service logs --since 6h <stack_name>_<service_name>Полный цикл проверок в логах#
Проверка длительности preconnect#
На этом этапе проверяется скорость ответа на вызов. Если она менее 4000 мс, вызов помечается как робот.
2025-02-14 11:49:45,359 | INFO    | [SC38.413.2760542.1744706978.1393793146]: Получили длительность preconnect: 5732
2025-02-14 11:49:45,359 | INFO    | [SC38.413.2760542.1744706978.1393793146]: Длительность preconnect больше чем 4000
Проверка на специальные сигналы в preconnect#
На этом этапе в preconnect-части записи ищутся специальные сигналы.
2025-02-14 11:49:45,359 | INFO    | [SC38.413.2760542.1744706978.1393793146]: Проверка на сигнал 800 hz включена
2025-02-14 11:49:45,363 | INFO    | [SC38.413.2760542.1744706978.1393793146]: Сигнал 800 hz не обнаружен
2025-02-14 11:49:45,364 | INFO    | [SC38.413.2760542.1744706978.1393793146]: Проверяем файл на SIT-сигнал [914, 1373, 1777]
2025-02-14 11:49:45,366 | INFO    | [SC38.413.2760542.1744706978.1393793146]: SIT-сигнал [914, 1373, 1777] в preconnect не обнаружен
Проверка на совпадение preconnect-записи с известными спектрограммами АО.#
На этом этапе сравнивается спектрограмма preconnect-файла. Если hashes_matched_in_input превышает Confidence level, считается, что на записи робот.
2025-02-14 11:49:45,522 | INFO    | [SC38.457.738194.1744706976.1396791494]: Отдаём файл pre_SC38.457.738194.1744706976.1396791494.wav на распознавание в Dejavu
2025-02-14 11:49:45,530 | INFO    | [SC38.457.738194.1744706976.1396791494]: Распознавание завершено: 0:00:00.008286
2025-02-14 11:49:45,531 | INFO    | [SC38.457.738194.1744706976.1396791494]:
    Время обработки Dejavu:
        Total time: 0.008 ms
        fingerprint_time: 0.005 ms
        query_time: 0.001 ms
        align_time: 0.001 ms
2025-02-14 11:49:45,531 | INFO    | [SC38.457.738194.1744706976.1396791494]:
    Ближайшее совпадение:
        song name: sit_абонент_временно_недоступен_жен
        input_total_hashes: 30
        fingerprinted_hashes_in_db: 614
        hashes_matched_in_input: 12
        input_confidence: 0.4
        fingerprinted_confidence: 0.02
        offset: 43
        offset_seconds: 11.008

2025-02-14 11:49:45,531 | DEBUG   | [SC38.457.738194.1744706976.1396791494]: Confidence level для данной проверки: 20
2025-02-14 11:49:45,531 | INFO    | [SC38.457.738194.1744706976.1396791494]: Совпадения не найдены, считаем что на записи человек
Проверка postconnect-части#
В первую очередь файл анализируется на наличие 425 Гц сигналов.
2025-02-14 11:49:39,625 | INFO    | Asterisk закончил CPD и прислал запрос: {'phone_number': 'SVD89000991962', 'amd_status': 'NOTSURE', 'confidence_level': '12', 'amd_cause': 'TOOLONG-5003', 'calluuid': 'SC38.446.27230.1744706971.1665682949', 'lstm_control_group_size': '0', 'preconnect_duration': 'INVITE|1744706972.7382;ACK|1744706976.8882', 'content': 'post_SC38.446.27230.1744706971.1665682949', 'client_id': '0022233301'}
2025-02-14 11:49:39,625 | DEBUG   | [unknown]: Проверяем есть ли папка для клиента ./0022233301
2025-02-14 11:49:39,627 | DEBUG   | [SC38.446.27230.1744706971.1665682949]: Получили NOTSURE от астериск, прогоняем файл через SmartCPD
2025-02-14 11:49:39,628 | INFO    | [SC38.446.27230.1744706971.1665682949]: Размер файла: 43884
2025-02-14 11:49:39,632 | INFO    | [SC38.446.27230.1744706971.1665682949]: Файл 'post_SC38.446.27230.1744706971.1665682949.wav' успешно скопирован.
2025-02-14 11:49:39,632 | INFO    | [SC38.446.27230.1744706971.1665682949]: Проверка на сигнал 425 hz в postconnect включена
2025-02-14 11:49:39,635 | INFO    | [SC38.446.27230.1744706971.1665682949]: Сигнал 425 hz в postconnect не обнаружен
Далее происходит сравнение файла с известными спектрограммами.
2025-02-14 11:49:42,100 | DEBUG   | [SC38.68.5121197.1744706967.700169291]: Отдаём файл post_SC38.68.5121197.1744706967.700169291.wav на распознавание в Dejavu через локальную базу
2025-02-14 11:49:42,115 | DEBUG   | [SC38.68.5121197.1744706967.700169291]: Распознавание завершено (local db): 0:00:00.015167
2025-02-14 11:49:42,116 | DEBUG   | [SC38.68.5121197.1744706967.700169291]: Отдаём файл post_SC38.68.5121197.1744706967.700169291.wav на распознавание в Dejavu через облачную базу
2025-02-14 11:49:42,151 | DEBUG   | [SC38.68.5121197.1744706967.700169291]: Распознавание завершено (cloud db): 0:00:00.035451
2025-02-14 11:49:42,152 | INFO    | [SC38.68.5121197.1744706967.700169291]: Результат local отсутствует.
2025-02-14 11:49:42,152 | INFO    | [SC38.68.5121197.1744706967.700169291]: Результат cloud:
2025-02-14 11:49:42,152 | INFO    | [SC38.68.5121197.1744706967.700169291]:
    Время обработки Dejavu:
        Total time: 0.034 ms
        fingerprint_time: 0.012 ms
        query_time: 0.017 ms
        align_time: 0.005 ms
2025-02-14 11:49:42,152 | INFO    | [SC38.68.5121197.1744706967.700169291]:
    Ближайшее совпадение:
        song name: autoetalon__17-09-2024__bfbdafd7-9bb6-4bb1-8be7-07ddd39a2e84
        input_total_hashes: 290
        fingerprinted_hashes_in_db: 262
        hashes_matched_in_input: 8
        input_confidence: 0.03
        fingerprinted_confidence: 0.03
        offset: -8
        offset_seconds: -2.048

2025-02-14 11:49:42,152 | INFO    | [SC38.68.5121197.1744706967.700169291]: Сохраняем результат cloud для дальнейшей работы
2025-02-14 11:49:42,152 | DEBUG   | [SC38.68.5121197.1744706967.700169291]: Confidence level для данной проверки: 12
2025-02-14 11:49:42,153 | INFO    | [SC38.68.5121197.1744706967.700169291]: Совпадения по Dejavu не найдены
Далее запись анализируется через LSTM-классификатор:
2025-02-14 11:49:11,441 | INFO    | [SC38.73.2482051.1744706940.895521319]: Используемая LSTM-модель: pcm16_2025-03-16_v1_ep10_state
2025-02-14 11:49:11,453 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: Время выполнения LSTM-проверки: 0.01 секунд
2025-02-14 11:49:11,454 | INFO    | [SC38.73.2482051.1744706940.895521319]: Результат классификации: 0
2025-02-14 11:49:11,454 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: Классификатор считает что на записи человек
Далее запись анализируется на наличие в ней ключевых слов:
2025-02-14 11:49:11,454 | INFO    | [SC38.73.2482051.1744706940.895521319]: Проводим дополнительный анализ через VOSK-модуль
2025-02-14 11:49:11,456 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: VOSK - Создаём KaldiRecognizer
2025-02-14 11:49:11,457 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: VOSK - Время создания KaldiRecognizer: 0.00 секунд
2025-02-14 11:49:11,468 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: VOSK - Время выполнения ffmpeg: 0.01 секунд
2025-02-14 11:49:11,622 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: VOSK - Время на транскрибацию: 0.17 секунд
2025-02-14 11:49:11,622 | INFO    | [SC38.73.2482051.1744706940.895521319]: VOSK - Результат транскрибации:
2025-02-14 11:49:11,623 | INFO    | [SC38.73.2482051.1744706940.895521319]: Распознано через VOSK:
2025-02-14 11:49:11,623 | DEBUG   | [SC38.73.2482051.1744706940.895521319]: Ключевые слова НЕ обнаружены
2025-02-14 11:49:11,624 | INFO    | [SC38.73.2482051.1744706940.895521319]: Совпадения не найдены, считаем что на записи человек
Если ни одна проверка не дала положительный результат, вызов помечается как «Человек».
Типовые ошибки#
Ошибка в работе Dejavu#
[2025-02-08 09:00:46 +0300] [32] [ERROR] [04b0aad8-7322-4477-8ab2-69ab1b9466a6]: Ошибка в проверке Dejavu:Данная ошибка может встречаться, если файл базы данных повреждён.
Требуется запросить у вендора актуальные файлы и загрузить их в систему через веб-интерфейс.
Ошибка в работе LSTM#
[2025-02-08 16:51:46 +0300] [32] [ERROR] [aa5b1b40-536d-4531-1dbd-c189e509845e]: Не удалось выполнить LSTM_CLASSIFIER проверку:Данная ошибка может встречаться, если файл модели повреждён.
Требуется запросить у вендора актуальный файл и загрузить его в систему через веб-интерфейс.
Прочие ошибки#
Требуется проверить логи на предмет ERROR, которые не описаны выше. При их наличии следует обратиться к вендору.
Контроль запуска и работы сервисов#
Команды для базовой диагностики:
docker stack services <stack_name>показывает текущее состояние всех запущенных сервисов.docker service ps --no-trunc <stack_name>_<service>показывает состояние всех задач сервиса.docker service logs <stack_name>_<service>показывает логи всех экземпляров сервиса. Дополнительные флаги:-fобновляет вывод в реальном времени.--since 2mпоказывает логи за последние две минуты.
Общие проблемы#
no suitable node#
Такая ошибка в docker service ps означает, что в Swarm нет подходящей ноды, удовлетворяющей требованиям запуска сервиса.
- Для сервиса
smartcpdнеобходимо убедиться, что на нужной ноде есть минимум5 GBсвободной RAM до запуска сервиса. - Для остальных сервисов:
проверить соответствующие
labelsна нодах и добавить недостающие; попробовать пересоздатьlabels, если они заданы верно (docker node update --label-rm/--label-add); удалить сервис (docker service rm <stack_name>_<service>) или весь стек (docker stack rm <stack_name>), если проблема возникла при инсталляции, затем пересоздатьlabelsи заново выполнить развертывание черезsmartcpd-setup.sh; в крайнем случае выполнить предыдущий вариант с перезапускомdocker.serviceпосле удаления стека.
error while mounting volume#
Такая ошибка в docker service ps означает, что отсутствует или неверно указана директория (metrics_data, node_records или node_results). Необходимо создать директорию или указать корректный путь через smartcpd-setup.sh.
Сервисы не стартуют#
Если состояние сервисов в docker stack services <stack_name> равно 0/x, сервисы созданы, но не запускаются, а docker service ps не показывает ошибок.
Необходимо проверить логи docker.service на всех хостах на предмет ошибок и устранить их.
Давление на память, swap и swappiness#
Кратко о роли swap в Linux#
Swap в Linux является частью политики управления памятью, а не только аварийным резервом на случай исчерпания RAM.
Ядро стремится использовать оперативную память эффективно, в том числе под page cache. Для этого оно может заранее выгружать в swap “холодную” анонимную память, чтобы:
- сохранить
page cache; - подготовиться к будущим выделениям памяти;
- снизить фрагментацию памяти;
- уложиться в ограничения
cgroup.
Важно различать два состояния:
- swap занят: в нем лежат страницы, выгруженные ранее; это может быть следом прошлых пиков нагрузки и само по себе не означает проблему;
- свопинг идет сейчас: происходят операции чтения из swap или записи в swap, что создает нагрузку на диск и может давать задержки.
Типичная ситуация: swap занят, но система продолжает работать быстро. Это нормально, если чтение из swap почти не происходит, а запись в swap носит эпизодический характер.
Почему это важно для SmartCPD#
Для отдельных задач обработки SmartCPD может требоваться большой объем памяти. После завершения такой задачи значительная часть памяти освобождается, но ранее использованные анонимные страницы могут оставаться в swap.
На практике это особенно заметно для сервисов smartcpd и amd, которые при отдельных типах детекций и всплесках нагрузки могут потреблять значительные объемы RAM.
Если такие страницы снова понадобятся, система будет вынуждена читать их обратно из swap, что повышает задержки и может ухудшать время обработки вызовов.
Основные причины свопинга#
- Нормальная политика ядра: часть “холодной” анонимной памяти вытесняется в swap, чтобы сохранить файловый кэш.
- Ограничения
cgroup: контейнер или сервис достиг лимита памяти и начал свопить, хотя на уровне хоста еще остается свободная память. - Реальный дефицит доступной памяти:
MemFreeможет быть ненулевым, ноMemAvailableуже мало, и система работает под давлением памяти.
Диагностика#
Занятое место в swap не означает, что свопинг происходит прямо сейчас. Для проверки в реальном времени удобно использовать:
vmstat 1Ключевые поля:
si—swap in, чтение страниц из swap в RAM; обычно это самый чувствительный к latency показатель;so—swap out, запись страниц из RAM в swap; само по себе может быть допустимо, если это кратковременный эпизод.
Интерпретация:
- высокий
soпри низкомsi: ядро вынесло часть памяти в swap, но активного возврата страниц почти нет; это может быть нормальным; - регулярный высокий
si: процессы постоянно читают страницы из swap, что обычно приводит к задержкам; - одновременно растущие
siиso: признакthrashing, то есть выраженного дефицита памяти или слишком жестких лимитов.
Дополнительные команды:
free -h— общая картина использования RAM и swap;cat /proc/meminfo— детальные метрики памяти, при этомMemAvailableобычно важнее, чемMemFree;sar -B— исторические данные по page fault и свопингу, если утилита установлена.
Swappiness#
Параметр vm.swappiness определяет баланс между использованием swap и удержанием файлового кэша.
- низкие значения (
0-10) заставляют ядро как можно дольше избегать swap; - средние значения (
20-40) дают более нейтральный баланс; - высокие значения (
60+) делают использование swap более агрессивным.
Для latency-чувствительных сервисов SmartCPD обычно разумно начинать с низкого значения.
Проверить текущее значение:
sysctl vm.swappinessВременно изменить:
sysctl -w vm.swappiness=10Сделать настройку постоянной:
echo "vm.swappiness = 10" > /etc/sysctl.d/60-swappiness.conf
sysctl --system
Практические рекомендации для SmartCPD#
- наблюдать
MemAvailable, занятость swap и показателиsi/so; - при постоянном ненулевом
siили росте задержек обработки проверить лимиты контейнеров и общий запас RAM на ноде; - начинать тюнинг с
vm.swappiness = 10; - при использовании Docker memory limits закладывать запас по памяти относительно ожидаемого пика нагрузки;
- при устойчивом давлении на память предпочитать увеличение RAM или горизонтальное масштабирование
worker-контура, а не опору на swap как на рабочий механизм.
portal-frontend#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
2025/05/07 08:29:35 [notice] 1#1: start worker processesportal-api#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
Using gunicorn
2025-05-07 09:27:00 - gunicorn.access - INFO - 127.0.0.1 - - [07/May/2025:09:27:00 +0300] "GET /health HTTP/1.1" 200 0 "-" "curl/8.12.1"license-server#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
07.05.2025 06:49:22.148 [license-checker-pekko.actor.default-dispatcher-5] INFO Main$:33 - Application started on 0.0.0.0:8001billing-server#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
07.05.2025 09:41:15.848 [smartcpd-billing-service-pekko.actor.default-dispatcher-9] INFO HttpServer:122 - Application started on 0.0.0.0:8001metrics#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
2025-05-07T07:06:31.559Z info VictoriaMetrics/app/victoria-metrics/main.go:105 started VictoriaMetrics in 0.106 secondsОшибка прав на запись в директорию#
Сообщение об ошибке:
panic VictoriaMetrics/lib/fs/fs.go:362 FATAL: cannot create lock file: cannot create lock file "/storage/flock.lock": open /storage/flock.lock: permission denied; make sure a single process has exclusive access to "/storage"Возникает, если:
- у пользователя, под которым запущен сервис, нет прав на запись в целевую директорию
metrics_data. Назначение соответствующих прав целевой директории и всему её содержимому (sudo chown -R <uid> </path/to/metrics_data>) решает проблему без необходимости перезапуска сервиса. - одновременно запущено более одного экземпляра сервиса. Проверить, что для
metricsне задано более одного экземпляра в текущем stack bundle. Если это не так, пересобрать и заново выполнить развертывание черезsmartcpd-setup.sh. Это не затронет рабочие сервисы, если сохранился файлsmartcpd-setup.env.
Некорректные настройки подключения к docker API#
Сообщения об ошибке вида:
error VictoriaMetrics/lib/promscrape/config.go:842 skipping dockerswarm_sd_config targets for job_name=mgw because of error: cannot query dockerswarm api for nodes: cannot fetch "http://unix/nodes": Get "http://unix/nodes": dial unix /var/run/docker.sock: connect: permission deniedУказывают на невозможность (cannot query dockerswarm api) получить доступ к docker API и автоматически определить цели для сбора метрик. Проверить настройки Docker в разделе Настройка Docker для подключения к нему контейнеров.
grafana#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
logger=http.server t=2025-05-07T10:05:07.384839118+03:00 level=info msg="HTTP Server Listen" address=[::]:3000 protocol=http subUrl=/grafana socket=
logger=app-registry t=2025-05-07T10:05:07.627726098+03:00 level=info msg="app registry initialized"resolver#
- имеет встроенный
healthcheck
Пример сообщений об успешном запуске:
{
  "level": "info",
  "dockerInfo": {
    "APIVersion": "1.45",
    "OSType": "linux",
    "Experimental": false,
    "BuilderVersion": "2",
    "SwarmStatus": {
      "NodeState": "active",
      "ControlAvailable": true
    }
  },
  "time": 1746621769377,
  "caller": "cmd/main.go:76",
  "message": "Connected to docker daemon"
}
{
"level": "info",
"time": 1746621769378,
"caller": "cmd/main.go:93",
"message": "Starting DNS server on 0.0.0.0:3535"
}Некорректные настройки подключения к docker API#
Сообщения об ошибке вида:
{
  "level": "fatal",
  "error": "Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?",
  "time": 1746622040503,
  "caller": "cmd/main.go:74",
  "message": "Failed to connect to docker daemon"
}
Указывают на невозможность (Failed to connect to docker daemon) получить доступ к docker API. Проверить настройки Docker в разделе Настройка Docker для подключения к нему контейнеров.
mgw#
- имеет встроенный
healthcheck
При успешном старте печатает список прослушиваемых интерфейсов:
Listening on
             udp: NODE_IP [NODE_IP]:5060
             udp: NODE_IP [NODE_IP]:5050
Aliases:balancer#
- имеет встроенный
healthcheck
При успешном старте печатает параметры прослушиваемого интерфейса:
Listening on
             udp: NODE_IP [NODE_IP]:5060
Aliases:
Если для балансера настроено определение воркеров по DNS, на старте приложение пробует разрешить их адреса. В случае успеха выводится сообщение о добавлении найденных воркеров:
May 23 08:01:05 [21] NOTICE:[DISPATCHER] insert new worker sip:WORKER1:5060
May 23 08:01:05 [21] NOTICE:[DISPATCHER] insert new worker sip:WORKER2:5060
Это же сообщение печатается при любом изменении состава воркеров (удаление/добавление). По завершении разрешения состава воркеров выводится сообщение об успешном обновлении списка воркеров:
May 19 08:33:38 [26] NOTICE:***Update dispatcher***Ошибка 503 Service Unavailable при совершении звонка#
Проверьте логи на наличие сообщения:
May 23 08:18:16 [32] NOTICE:ds_not_in_list 10.0.0.1, 5060В сообщении представлена информация об источнике INVITE запроса, в примере это IP 10.0.0.1 и порт 5060. Для целей диагностики следующим сообщением будет:
May 23 08:18:16 [32] NOTICE:INVITE srcIP=10.0.0.1, srcPort=5060, via=SIP/2.0/UDP 10.0.0.1:15060;branch=z9hG4bKPj77be2383-de99-46d2-8501-b762fa64acc0Эти сообщения информируют о поступлении запроса от неизвестного источника. Параметр via содержит информацию о заголовке VIA SIP-запроса. Важно, чтобы srcIP источника и доменная часть заголовка были одинаковыми: различие указывает на наличие трансляции адресов. В качестве параметров SIP-подключения на портале должны быть корректно указаны IP-адрес источника, соответствующий доменной части заголовка via, и порт, с которого отправляется сигнализация. Если на стороне SBC используется динамический выбор порта, следует указывать порт из заголовка. В приведённом примере верной настройкой на портале будет адрес 10.0.0.1 и порт 15060.
amd#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
[May 19 08:04:44] Asterisk Ready.Если на ноде настроена запись CDR, но БД недоступна, печатается предупреждение об ошибке подключения к БД. При этом сервис продолжает работать, но данные о звонках теряются:
[May 19 08:15:26] ERROR[1]: cdr_pgsql.c:771 config_module: Unable to connect to database server 127.0.0.1.  CALLS WILL NOT BE LOGGED!!
[May 19 08:15:26] ERROR[1]: cdr_pgsql.c:772 config_module: Reason: connection to server at "127.0.0.1", port 5432 failed: Connection refused
Is the server running on that host and accepting TCP/IP connections?dircleaner#
- имеет встроенный
healthcheck, который проверяет разрешения для директорий
С заданными настройками интервала проверки, печатает сообщение о сканируемых директориях:
[RECORDS] Cleaning: 2m old files in /store/records/ with filter *
[RESULTS] Cleaning: 1d old files in /store/results/ with filter *smartcpd#
- имеет встроенный
healthcheck
ВНИМАНИЕ: healthcheck проверяет наличие лицензионного файла, в случае его отсутствия контейнер будет постоянно перезагружаться!
Пример сообщения об успешном запуске:
INFO: Application startup complete.analyzer#
- имеет встроенный
healthcheck
Пример сообщения об успешном запуске:
INFO: SmaptCPD_Analyzer started